まえがき
オントロジーの話題が盛り上がってきているので、そういえばIoTプラットフォームをやっていたときに書いた記事があったなとチャッピーと対話していたら、ほぼ完成品のブログ記事をまるっと全部書いてくれたので、納得して満足しちゃったんですよね。さすがにこれをそのまま自分のブログとして載せる気にはならなくて、SNSに放流*1だけしていたのですが、あらためて自分の中でのオントロジーの位置付けを整理しておきたくなり、記事としてまとめなおすことにしました。
入口はIoTの経験から
この話の入口は、IoTのデータ処理について6年前に書いた記事です。センサーから上がってくる値を、データの形を決めるシンタックス、値の意味を細かく決めるセマンティクス、履歴や外部データと結び付けて価値を見いだすコンテキストの三層として整理しました。
先日この記事を「単位を揃えよう、意味を合わせよう、文脈に紐付けよう」と自分で要約し直した*2のですが、あらためて読み返すと少し違いました。当時書いていたのは、温度は摂氏、湿度は百分率、位置はWGS 84と「数字の意味を細かく決めていく」こと。揃えることではなく、決めて明示することです。すべてを同じ単位へ正規化する必要はなく、どの物理量で、単位は何で、どう変換できるかを機械が判別できればいい。
Palantir文脈で「オントロジー」を聞く機会が増えましたが、現場に降ろそうとすると急にわからなくなります。SQLなのか、用語集なのか、RDFとOWLなのか。この記事ではこう捉えます。
現実世界の対象や出来事について、その型・性質・関係・制約・操作を、人と機械が共有できる形にしたもの
-8.4を-8.4のままにしない
たとえば、センサーからこんなデータが届いたとします。
{ "device_id": "A17", "timestamp": "2026-07-15T01:23:45Z", "value": -8.4 }
JSONとして正しいですが、業務上はほぼ何もわかりません。「-8.4」とは温度なのか、摂氏なのか、あるいは絶対温度……はさすがにないか。timestampは観測時刻なのか、センサーはどこに付いていたのか。そこで意味と文脈を足します。
type: Observation
observedAt: 2026-07-15T01:23:45Z
madeBySensor: Sensor/A17
featureOfInterest: Freezer/3
observedProperty: AirTemperature
result: { value: -8.4, unit: Cel }
これで「センサーA17が、冷凍庫3番の庫内温度を摂氏マイナス8.4度と観測した」という事実になります。さらに冷凍庫3番に保管されているアイスクリームのロットと温度ポリシーを関係で結べば、「許容上限を10分超過→温度異常→ロットを保留し点検開始」という判断と操作までつながります。シンタックス→セマンティクス→コンテキスト→識別と関係→制約・検証→判断とアクション、という階段です。
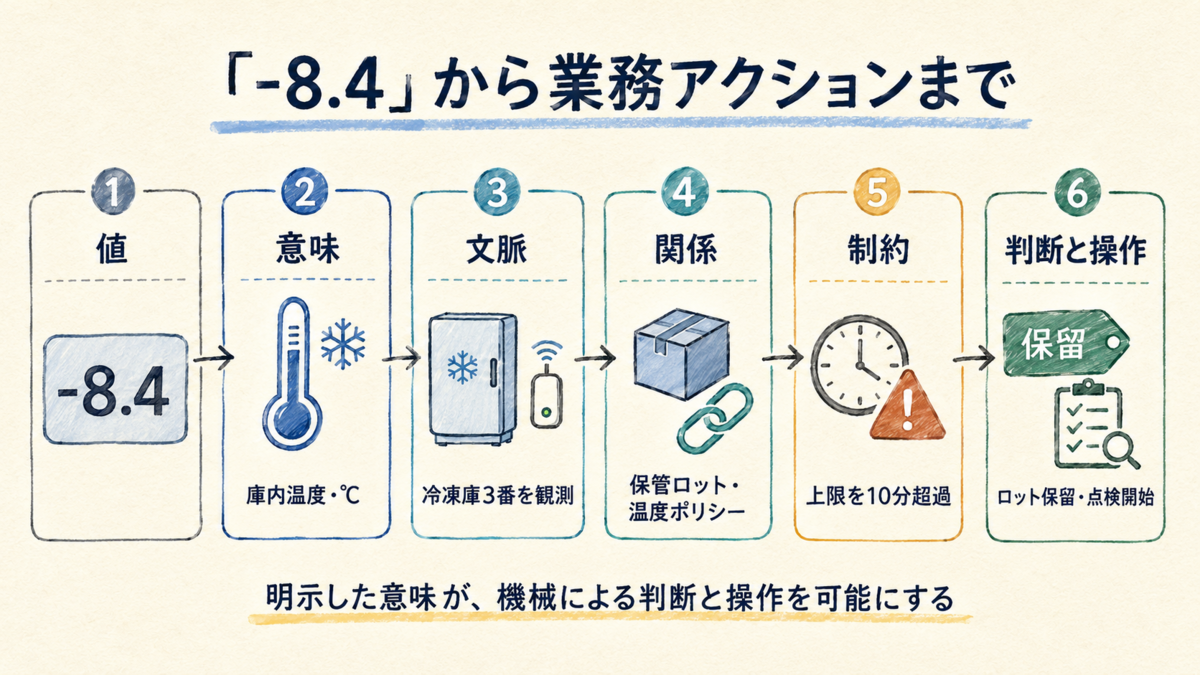
そして、ここまで明示すると「型推論」のようなものが効き始めます。unit: Cel があれば華氏への変換も「気温は平均してよいがIDは平均できない」という集計の選択も機械が判断できますし、OWLで「madeBySensorの主語はObservationである」と定義しておけば、関係を書いただけで型が推論されます。プログラミング言語の型推論とは別物ですが、「明示した分だけ、書かなくても導かれることが増える」という感覚はよく似ています。効いてくるのは正確には、意味的な型付け・検証・推論の三点セットです。
第一歩は、-8.4をただの-8.4のままにしないこと。
オントロジーは業務用語辞書ではない
「顧客とは○○である」と書くだけではシステムは動きません。営業の「顧客」と請求の「契約者」とプロダクトの「ユーザー」は、重なっても同じとは限りません。「意味を合わせる」とは全社で一つの言葉を使うことではなく、意味の違いと対応関係を機械が扱える形にすることです。最初から全社共通の巨大モデルを狙うと、すべてを支配する一つのオントロジーより先に、すべてを支配する定例会議が生まれます。限定された業務課題から始めるのが正解です。
寄り道: セマンティックWebが残したもの
オントロジーの源流にはセマンティックWebがあります。対象をURIで識別し、関係をRDFで書き、語彙をOWLで定義して、独立に作られたデータを横断利用しようという構想です。
遠い話に聞こえますが、2000年代にブログをやっていた人は体の一部で触れています。RSS 1.0の正式名称は「RDF Site Summary」で、フィードの先頭にはこう書いてあったはずです。
<rdf:RDF xmlns:rdf="http://www.w3.org/1999/02/22-rdf-syntax-ns#"
         xmlns:dc="http://purl.org/dc/elements/1.1/">
この xmlns:dc が指すDublin Coreは、タイトル・作成者・日付など15要素だけの小さなメタデータ語彙です(ちなみにこのダブリンはアイルランドではなくオハイオ州)。名前空間URIは「この語彙の意味はこの住所で一意に定まる」という仕組みで、理屈としては実にしっかりした枠組みでした。ただ、そのしっかりさが曲者で、書く側の実態は「動くと聞いたxmlnsの行をコピペする」呪文詠唱に近かった。枠組みは厳密なのに、書き手の理解と動機が追いつきませんでした。とはいえ、LLMのように文脈から柔軟に意味を汲んでくれるエンジンがない時代では、機械に意味を伝えるには、厳格に定義した語彙を正確に一致させるしかなかった、とも言えます。
白状すると、初稿では「うちのはてなブログの/rssは今もRSS 1.0だ」と書いていました。確認したらRSS 2.0で、dc:の宣言ごと消えていました。それでもdc:はあちこちにその足跡を残しています。WordPressのRSS 2.0フィードには今も dc:creator が付いていますし、学術機関や図書館で使われるOAI-PMHではDublin Core(oai_dc)が基盤になっています。フルセットとしては残らず、名札が残りました。
セマンティックWebが残した最大の教訓は、「記述形式を統一しても、意味は自動的には揃わない」ということです。仕組みの上では誰でも語彙を定義して公開でき、実際に何百という語彙が生まれました。でもその先には壁が並んでいます。誰が定義を保守し続けるのか。何を同一とみなすのか。定義を変えたら誰が困るのか。そもそも、書く側にどんな利益があるのか。この壁を全部越えて広く使われるに至った汎用語彙は、Dublin Coreを筆頭に数えるほどしかありません。
意味を揃えるために本当に必要だったのは、記述形式ではなく、定義を保守しつづける主体と書く動機のほうでした。セマンティクスは技術の問題であると同時に、組織設計とガバナンスの問題です。
もう一つの教訓が、推論と検証は別の仕事だということ。OWLは公理からの知識導出が得意ですが、「記述されていない事実は偽」とはみなさないオープンワールド仮定を採るため、「観測時刻は必須」のような入力検証には向きません。だから検証にはSHACLが別途標準化されました。この区別は、JSON SchemaやDB制約、dbtのテストを設計するときにそのまま効きます。
普及についてはSchema.orgの教訓があります。「この語彙で書けば検索結果がリッチになる」という具体的な利益を用意したから広まった。たとえばレシピページにこう書いておくと、検索結果に星付きの評価が表示されるようになります。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Recipe",
  "name": "冷凍庫3番の管理者を労うチョコモナカジャンボ",
  "aggregateRating": { "@type": "AggregateRating",
                       "ratingValue": "4.8", "ratingCount": "84" }
}
</script>
もっと身近な例はOGPです。SNSでリンクカードを出すために、誰もがこう書いています。
<meta property="og:title" content="オントロジー:セマンティックWebからFDEのその先まで" />
<meta property="og:type" content="article" />
実はこれ、RDFa由来の仕様で、og: は名前空間のプレフィックスです。正式には <html prefix="og: https://ogp.me/ns#"> と宣言するのですが、省略してもクローラーのほうが解釈してくれます。つまり、あの頃コピペしていたxmlnsの呪文は、形を変えて今も全員が書いている。違いはただ一つ、貼ればすぐにカードや星という見返りが返ってくることです。意味付けのコストに見合う利益が見えると、人は動きます。
PalantirとFDE
企業向けに語られるオントロジーは、この問題意識を、境界と責任主体が明確な組織の中へ持ち込んだものです。PalantirのOntologyは、対象をObject・性質をProperty・関係をLinkとする「semantic elements」に加え、ActionやFunctionで業務を動かす「kinetic elements」を持ちます。意味を記述するだけでなく、組織が認識している世界と、そこに対して実行できる操作をモデル化します。
このモデルを作るために現場へ入るのがForward Deployed Engineer(FDE)です。現場の人が何を見て判断しているかを調べ、部門ごとの用語の衝突を調整し、例外と責任分界を見つけ、モデルをアプリと業務操作に落とす。Before LLMの世界では、この一連を人間がほぼ手作業でつないでいました。FDEとは、現場の言葉・データの言葉・ソフトウェアの言葉を行き来する、人間のアダプターでした。
LLMは意味を掘り出せるが、決められない
LLMはこのコスト構造を変えます。DDL、SQL、API仕様、議事録を横断的に読み、どのテーブル群が一つの業務オブジェクトか、二つのカラムが同じ概念か、といった候補を出し、変換コードもテストも下書きできます。すでに書かれたものを手がかりに「たぶんこういう意味だろう」を掘り出す仕事は、劇的に速くなりました。Palantir自身も「AI FDE」というエージェントを出しています。
しかしLLMが掘り出せるのは、既存情報から見て「もっともらしい意味」まで、です。契約主体と利用者のどちらを顧客と呼ぶのか。解約済みは今も顧客なのか。CRMと請求システムのどちらを正とするのか。これらはデータをいくら読んでも一意に決まらない、「業務上の境界を決める問題」です。しかも決めた定義には、いつから適用するのか、どの範囲に効くのか、変えるときは誰の承認が要るのか、が付いてまわり、売上集計やアクセス権や法令対応に波及します。掘り出す仕事は速くなりましたが、これからの意味を決めて組織に効かせる仕事は、人間側に残ります。
全自動を信じるのも楽観的すぎます。2025年のPVLDB論文では、LLMによるカラムの意味型付与が、公開ベンチマークではそこそこでも実際のSAP由来データでは大きく落ち、社内固有項目は内部知識なしにほぼ対応できませんでした。ZZ_STAT や KUNNR は、社内の運用を知らなければ解釈できません。データは長い歴史を圧縮した地層で、考古学者役のLLMも、発掘現場の人に聞かないと年代を盛大に間違えます。
つまり関係は双方向になります。LLMがオントロジーの候補を作り、「オントロジーがあるからLLMが企業内でまともに働ける」。コンテキストを整えずにAIを入れると、知性が増えるのではなく、曖昧さが高速に増幅されます。
人間の仕事は「記述」から「決定」へ
人間の仕事は、項目を一つずつ読んで対応表へ転記することから、どの業務判断をモデル化するか、どの概念を公式に採用するか、どの推論とアクションを自動化してよいか、誤った意味付けがどんな損害を生むか、へ移ります。写経する人から、意味を編集し、決める人へ。コードを書く量が減っても責任は減りません。一人の判断がAIを通じて大量のデータと操作に適用されるので、レバレッジと危険性が両方増えます。
実践形は「LLMが提案し、決定的な仕組みが検証し、人間が承認する」ループです。変更はリスクに応じてレビュー強度を変えます。表示名の追加は自動適用、マッピング候補は担当者レビュー、同一性ルールの変更は複数人承認、請求や在庫に関わるActionは厳格な監査。AIエージェントに渡す権限の設計は、事前の制約と事後の監査の組み合わせ問題になっていきます。
現場では何から始めるか
専用製品は要りません。DB、JSON Schema、dbt、ワークフローエンジンで実装できます。まず業務上の判断やアクションを一つ選びます。「温度異常が起きたら影響ロットを特定して点検を開始する」くらいの粒度でいい。そこから逆算して、対象と出来事を列挙し、ID・単位・時刻・関係・出典を明示し、制約と判定ルールを定義し(推論と検証は分けて)、アクション・権限・監査へつなぎ、LLMに候補を作らせて人間が承認します。重要なのは使った製品ではなく、何を明示的にモデル化したかです。そして「これを整備すると誰のどの判断が速くなるか」を最初に言えるようにしておきます。
おまけ: 次の2年の軽い仮説
2028年の自分が答え合わせできるように書いておきます。
1. 「意味の編集者」が職種としてあらわれる
LLMが調査と実装を安くした結果、残った「意味の決定と承認」が独立した職能になり、コンテキストエンジニアやオントロジースチュワードといった肩書が2年以内に求人票に現れる。PMとデータエンジニアの間に空いていた椅子が名前を持ちます。
2. 意味の変更がプルリクエストになる
用語集がWikiで腐る時代が終わり、オントロジーと検証ルールがGit管理され、LLMがブランチで提案し人間が承認する形が標準になる。dbtやSHACLのテストは意味の回帰テストとしてCIに載ります。人間がレビューする中間表現として、小さなDSLが増えるはずです(これは別の記事で書きます)。
3. アクション設計の第一級要件が「取り消せるか」になる
全操作を事前ガードレールで縛るのは無理筋で、可逆な操作は事後監査つきで緩く許可し、不可逆な操作だけ厳格に承認するポートフォリオ設計に振れる。冪等性とロールバック可能性がAction定義の標準フィールドになります。
外れたら2028年に笑ってください。
おわりに
現場での第一歩は6年前から変わらず地味です。単位を明示する。意味を定義する。対象・時刻・出典に結び付ける。そこまで整えると、意味的な型付け・検証・検索・導出、いわば意味の世界の型推論がうまく効き始めます。
LLMは意味の探索と記述を安価にしました。冒頭の「チャッピーが全部書いてくれて満足しちゃった」も、書くだけなら安価になったがゆえの風景です。でも、どの意味を採用し、どこへ適用し、誰が責任を持つかを決める仕事は、まったく安くなっていません。あのとき、よく書けた下書き*3をそのまま自分のブログに載せる気にならなかったのは、たぶんこの仕事がまるごと残っていたからです。
AI時代に問われるのは、誰が意味を「書く」かではなく、誰が意味を「決め」、その結果に責任を持つのか、です。
参考リンク
- IoTデータ処理の考え方(2020): https://d.nekoruri.jp/entry/2020/08/11/iot-data-processing
- W3C SSN/SOSA: https://www.w3.org/TR/vocab-ssn/
- W3C OWL 2 Primer: https://www.w3.org/TR/owl2-primer/
- W3C SHACL: https://www.w3.org/TR/shacl/
- Dublin Core (DCMI Metadata Terms): https://www.dublincore.org/specifications/dublin-core/dcmi-terms/
- Schema.org: https://schema.org/
- Palantir Ontology: https://palantir.com/docs/foundry/ontology/overview/
- Palantir AI FDE: https://palantir.com/docs/foundry/ai-fde/overview/
- Unveiling Challenges for LLMs in Enterprise Data Engineering (PVLDB 2025): https://www.vldb.org/pvldb/vol19/p196-bodensohn.pdf
*1:https://x.com/nekoruri/status/2077533500492874147
*2:https://x.com/nekoruri/status/2075487743682159079
*3:「よく書けた下書き」という表現はAIが書きました
