【この記事はもちろんAIを使って書かれています】
簡潔版(2026-08-16追加)
AIと長編を書くとき、プロンプトより重要だったもの
ClaudeやChatGPTと技術書を改稿した。章ごとの草稿はそれぞれ読めるものの、一冊にまとめると表現が重複し、章間の参照や予定していた説明が抜けた。AIの会話セッションは、本全体についての編集判断を共有していないからだ。
そこで、目次、ページ配分、章間の依存関係、未検証の主張、重要な言い回しをファイルにまとめた。各セッションの開始時にそのファイルを読ませ、作業後に新しい判断を書き戻すようにした。
さらに、各章が何を引き継ぎ、何を説明し、何を次章へ渡すかを決めた。同じ比喩や決め台詞を何度使うか、変わりやすい情報を本文とデジタル付録のどちらに置くか、主張をどの資料で裏づけるかも一覧化した。私は、こうした編集ルールを「執筆契約」と呼んだ。
重複表現、ページ数、参照漏れなど、機械で判断しやすい問題はスクリプトで検査した。一方、文章の自然さ、技術的な妥当性、安全性は人が判断した。自動検査の役割は、良い文章を保証することではなく、すでに分かっている失敗を繰り返さないことにある。
ただし、ルールは多ければよいわけではない。ルールを守った結果、必要な説明や文章のリズムが失われることもあった。その場合は、ルールを外した案と比較し、原稿ではなくルールのほうを見直した。
過去のノートも、AIに答えを作らせるためではなく、原稿に足りない材料を探すために使った。必要な情報は、改めて一次資料で確認した。
今回の経験から、次の本へ持ち越すべきなのは個々のルールではなく、失敗を記録し、検査可能なものを仕組みに変え、不要になったルールを捨てる手順だと分かった。AIによって文章を作る費用が下がるほど、何を採用し、なぜ直したかを残す編集工程が重要になる。
【ここから記事本体】
- 簡潔版(2026-08-16追加)
- 生成で可能性を広げ、望ましい可能性が残る条件を設計する
- 一章は書けても、一冊にはならなかった
- 壊れた場所から「執筆契約」が見えた
- 制約を一つのプロンプトへ押し込まない
- 制約自身を壊し、更新する
- 外部記憶は、答えではなく知識差分を探すために使う
- 次の本へ持ち込むのは、契約ではなく契約発見の仕組み
生成で可能性を広げ、望ましい可能性が残る条件を設計する
2026年の夏コミに向けて、『AIエージェントが見つけたサーバーレス——任せられる実行基盤の設計』を書きました。元になったのは、『サーバーレスを支える技術』と『サーバーレスのまわりの技術』です。
ただ二冊を足したわけではありません。体系的に書かれた本とコラム集をそのまま混ぜると、用語は多いのに筋が通らない「キーワード図鑑」になりかねないからです。既刊は、事実、図、過去における予測、比喩、設計上の問い、技術的な因果関係へいったん解体し、新しい問題設定のもとで組み直してあたらしい「サーバーレス総合書」としてまとめ直そうとしていました。
そこへAWS Lambda MicroVMsをはじめとするAIエージェント向け実行環境の発表が続きました。マイクロVM、スナップショット起動、ゼロスケール、短命な資格、ワークフロー。なるほど、追いかけるほど、サーバーレスが十年かけて磨いてきた、そして今まさにまとめ直していた原理・原則へと行き当たります。
そこで7月(元々の入稿予定は早割が効く7/11)に入ってから方針を切り替え、本書を「AIエージェントが、なぜサーバーレスの原理を必要としたのかを読む本」へ位置付け直し、書き直しはじめました。
この本をClaude、ChatGPT/Codexなどと書く中で、もう一つの再発見がありました。大切だったのは、望む文章を一度で出させるプロンプトの工夫ではありません。生成された候補のうち、何を残し、何を落とし、どの判断を次へ持ち越すかを設計することでした。
候補を生むだけでは、工学にならない。望ましい候補が残る条件を設計する。
一章は書けても、一冊にはならなかった
最初に壊れたのは、文体ではなく状態管理でした。もとの「まわりの技術」が2ページ1記事のコラム集であったこともあり、複数の会話セッションで章や節ごとに書いてもらうと、それぞれの出力は単独ではよくできています。ところが一冊につなげて読んでみると、同じキーフレーズや語り口が近い場所に現れ、あとで書く節に入れるはずだった一文は入れ忘れ、節番号を使った参照もずれました。個別の生成は成功していても、それでは本にならないのです。
人間は一冊を書きながら、「この表現は先ほど使った」「この比喩は後半へ取っておく」「この章では問いだけを渡す」といった判断を暗黙に保持しています。分割されたAIセッションは、その全書記憶を共有していません。
そこで、会話の中へ状態を積み上げるのをやめました。サーバーレスっぽく表現すれば、ファイルが状態で、チャットはステートレスな実行環境だと考えたのです。
各章の原稿ファイル末尾には、分量、構成判断、前後の章との接続、要確認事項、図版候補、キーフレーズを執筆メモとして残しました。本全体の状態は執筆キットへ集約し、目次、ページ予算、章間の依存、未執筆章への宿題、未検証の主張を持たせます。
新しい会話セッションは最新版の執筆キットを読み、担当部分を書き、通し調整を行い、新しい判断を執筆キットへ戻して加筆します。そして更新した執筆キットを次の会話セッションへ初回プロンプトとして渡す。長い会話を延命せず、短命な実行を耐久的な状態でつなぐcontinue-as-newの形です。
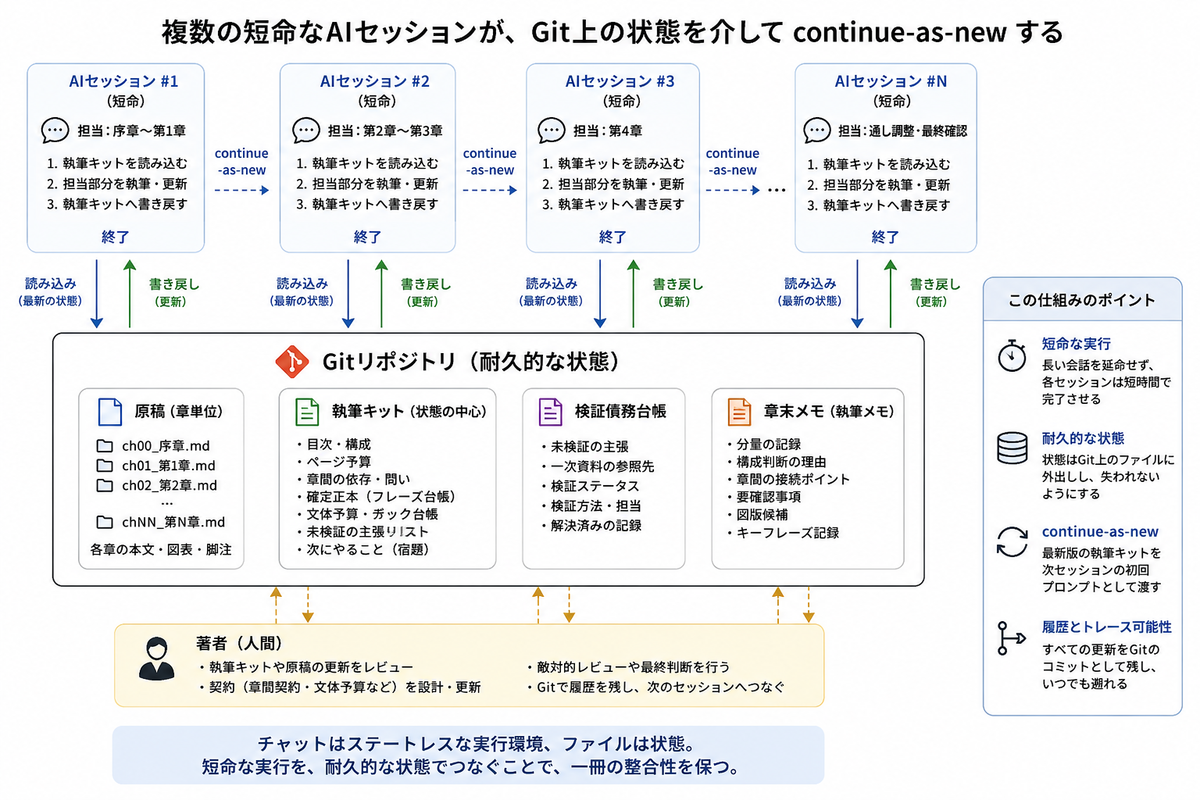
本の中では、短命な実行環境から状態を外へ出し、耐久的な記録で仕事をつなぐ技術(Durable Execution)を紹介しています。本を作る工程も同じ形になりました。
壊れた場所から「執筆契約」が見えた
状態を外へ出すだけでは、一冊の整合性は守れません。何が壊れたのかを言葉にすると、文体より広い「執筆契約」が見えてきました。
後の章が前の章の問いへ答えるなら、前の章にはその問いを置く義務があります。後続章が一文を引用するなら、先行章側で文言を固定する必要があります。これを被参照台帳として管理しました。章は、前章から未解決の対象を受け取り、混同を分け、判断に使える成果物を作り、次章へ宿題を渡す入出力を持っています。本にも章間インターフェースがありました。
「確定正本」とAIが名付けたフレーズ台帳も名言集ではありません。他章や巻末が依存する意味の置き場所です。ありがちな表現を台帳にした「文体チック」も悪い癖の一覧ではなく、「ここだけの話」「種明かしをすると」といった著者が使いがちな表現を、どの章へ割り当てるかを予算化して管理する台帳でした。
さらに、長く残したい原理を紙面に残し、料金や製品世代など変わりやすい情報はデジタル付録へ送る情報の寿命設計もあります。何を一次資料で支え、何を未検証として台帳へ残すかは、根拠管理として分けました。各部の最後には、単なる要約ではなく、部全体の判断を別の軸で並べ直す「思い返し装置」を無意識に置いていたことにも気づき、正式な執筆契約へ加えました。
| 種類 | 平たく言うと | 今回の例 |
|---|---|---|
| 章間契約 | 章どうしの受け渡し | 被参照台帳、問い、確定正本 |
| 文体と予算 | 書き方と使える量 | 文体基準、文体チック、反復密度 |
| 情報の寿命設計 | 情報をどこへ置くか | 紙の本文、デジタル付録 |
| 根拠管理 | 主張を何で支えるか | 一次資料、未検証リスト、検証シート |
| 出荷条件 | 何を満たせば出せるか | ページ、PDF、リリース検査 |
AIは、これらを最初から教えたわけではありません。生成された章をつないで通読したときの違和感から、人間が何を暗黙に守っていたのかをあぶり出しました。AIは文章を作る道具であると同時に、暗黙の編集判断を見つける手がかりにもなりました。
人間が確定した序章や前半章を、後続章の基準稿として使ったことは、実質的にfew-shotとして機能しました。文章は私の文体へ近づきましたが、対句、三項構成、決め台詞、問いかけ、比喩といった目立つ特徴も増えました。たとえば「同じ方向」「違う答え」「設計思想」という読み方は複数章に現れ、後に六か所から二か所へ減らしています。
few-shotは文体の傾向を伝えられても、その表現を使いまくってはいけないということまでは伝えていません。そこで、強い表現を文体予算として扱いました。一冊に一度だけ使う正本、一つの部をつなぐ比喩、近接してはいけない表現。強い表現は障害ではなく、適量なら文章のリズムを作り出す価値になります。文体予算は、著者らしさを減らすためではなく、使いどころを選ぶためにあります。
制約を一つのプロンプトへ押し込まない
ここまでを整理すると、制約は一つのプロンプトへ集めるものではなく、性質に応じて複数の層へ置くものでした。
| 層 | 平たく言うと | 今回の例 |
|---|---|---|
| 事前分布 | 材料と基準稿 | 種本、基準稿、一次資料、LLM Wiki |
| 表現空間 | 書き方の枠 | 章構成、表、執筆メモ、summary |
| 意味契約 | 守る意味 | 章間契約、確定正本、根拠管理 |
| 予算 | 使える量 | ページ予算、文体予算、チック |
| 検査 | 既知の壊れ方を落とす | 章構造、反復密度、ページ、PDF |
| 権限 | 到達できる作用を絞る | push、CI変更、履歴変更の承認 |
| 選択 | 人間による採否 | 二案比較、敵対的レビュー |
| 時間 | 契約の履歴と寿命 | 契約改定、落選正本、Git履歴 |
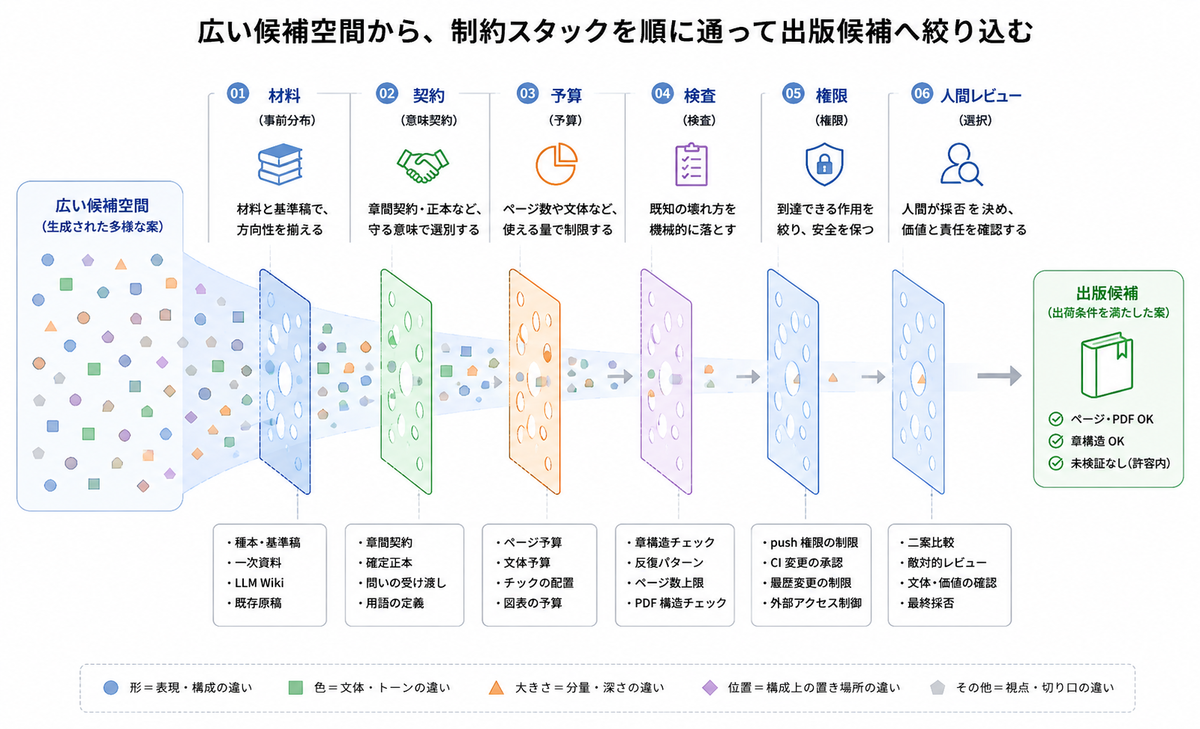
こうした制約を見つけ、適切な層へ置き、組み合わせ、効果を観測し、必要なら外すことを、「制約を工学する」と呼べそうです。
プロンプトやfew-shotは候補の出やすさを寄せるソフトな制約です。テスト、ページ上限、権限境界は、受理できない候補や作用を落とすハードな制約です。機械が正確に判定できるものほど硬い層へ置き、文脈に左右される判断ほど人間に近い層へ残しました。
同じ失敗が繰り返され、機械が比較的正確に判定できるものは、スクリプトへ移しました。確定正本の所在、文体チックの重複、章末の問いの数、ページ数、PDF構造などを検査します。「AIっぽい」という違和感も、「AではなくB」型、ダッシュ挿入、数え上げ、太字、スラッシュ連結といった反復パターンへ分け、章単位の上限と check_style_density.py へ落としました。
ただし、文章の品質を数値へ置き換えたわけではありません。良い文章はテストできませんが、既知の壊れ方はテストできます。 全検査へ通った原稿にも、費用と電力の関係を一般化しすぎた箇所、資格の自動失効によって可用性を壊し得る設計、遅延した実行との競合を防ぐ仕組みの不足が残っていました。これらはPR単位のレビューやコンテキストを初期化した敵対的レビューで見つかりました。
テストは人間を不要にするものではありません。同じ既知の事故を何度も探し直さずに済むようにするものです。自然さ、技術的な射程、安全性、反例、責任の引受先は、人間のレビューへ残ります。
制約自身を壊し、更新する
制約は多いほどよいわけではありません。入稿締切をなんとか延ばそうと、194ページを113ページ、58.2%まで圧縮した案は、図、表、脚注、正本、チックを維持し、全検査と、全ページの画像レビューをパスしました。それでも、この本にあるべき呼吸や、絶対に必要な説明が失われていたため採用しませんでした。
A5からB5に変更したときにも、AIが全書を一括で刈り込み、一度は上限へと収めました。しかし必要な文章まで落ちていると判断し、削減を復元しました。最終的には、空欄雛形を付録へ移し、重複する図を落とし、巻末を二層化し、著者が必要な箇所だけを再選別して112ページへ収めています。
| うまくいかなかった試み | 表面上の成功 | 実際に壊れたもの | 残った知見 |
|---|---|---|---|
| 58%へ圧縮 | ページ・検査・目視を通過 | 説明の間、本のリズム | ページ数を品質の目的関数にしない |
| AIによる一括削減 | 上限へ収容 | 必要な予備説明 | 候補抽出はAI、不可逆判断は著者 |
| 全自動検査 | 全段成功 | 技術的な射程と安全性 | 敵対的レビューを残す |
| 出典ID凍結の厳格化 | 不変条件を強化 | 正規の次刷作成 | 正規の工程を最初から最後まで通す |
| CIによる代替実行 | 必要な環境で処理 | レビュー可能性と権限境界 | 権限不足時は迂回せず相談する |
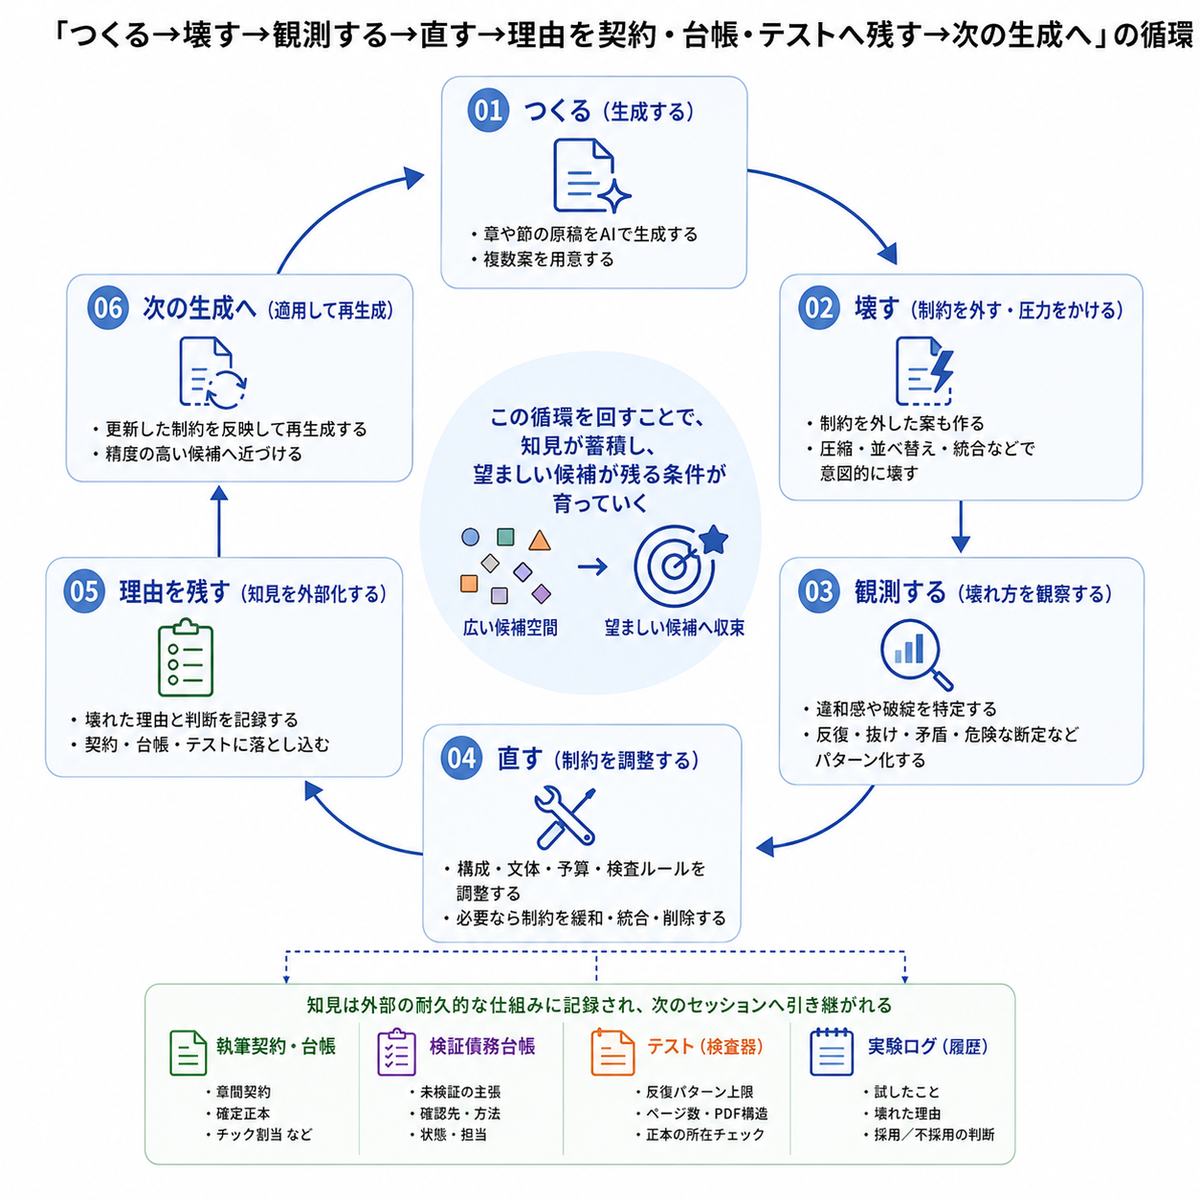
育てている契約が文章を守っているのか、不自然にしているのかを確かめるため、同じ章について二つの案も作りました。制約維持案では、章構造、確定正本、文体チック、章間契約を守ります。制約解除版では、それらをいったん外し、章の目的と入れるべき技術的内容から構成を組み直します。
解除版は、そのままでは完成稿になりません。後続章が依存する言葉や重要な限定が落ちることがあります。しかし、既存契約がなければ、章の中心語と因果がどこへ着地するかを見られます。最終稿では、解除版で見つけた自然な入口や表を維持案へ移植し、必要な正本と章間接続だけを戻しました。
これは、一度制約を外して何が崩れるかを見るアブレーション実験です。テストに落ちたことは、文章が間違っているという意味ではなく、過去の編集判断と違うという意味です。違いが意図的なら、本文ではなく契約を更新します。制約を追加するだけでなく、効果を観測し、緩和し、廃止するところまでが工学です。
外部記憶は、答えではなく知識差分を探すために使う
執筆途中から、元からメモやクリッピングを溜めていたObsidian環境でLLM Wikiを運用しはじめました。AIの知識を真実の源とせず、Markdownを保存先とし、AIは整理と探索を担います。
当時289本あった検証済みノートと完成済み原稿を突き合わせ、まだ原稿に使われていないが、加えると主張が強くなる情報を探しました。候補は本文、脚注、付録、追加検証、不採用へ分け、必要なものは一次資料から調べ直しました。LLM Wikiは答えではなく、過去の知識を候補空間へ戻し、原稿との差分を探すための長期記憶です。
ちなみに、このブログ記事を書くにあたっては、Claude、ChatGPT/Codexとの会話ログもLLM Wikiへ取り込み、「チック」「正本」「被参照台帳」などの言葉で発言を掘り、時刻をGitのコミットやPRと照合しました。Gitだけを見ると最初から存在していたように見える契約が、どの会話の違和感から生まれ、いつ台帳やスクリプトへ変わったのかを復元する、ちょっとした執筆考古学です。これはまた別の記事にまとめるつもりです。
次の本へ持ち込むのは、契約ではなく契約発見の仕組み
今回の流れは、候補を作り、反例を見つけ、その反例から次の制約を育てるCEGISという考え方にも少し似ています。今回の執筆を形式手法として設計したわけではありませんが、学習の形は近いものがあります。
章を生成する
    ↓
全書へ統合して読む
    ↓
同句重複、章間断絶、危険な断定を見つける
    ↓
再利用可能な失敗を契約・台帳・テストへ変える
    ↓
次の改稿へ適用する
    ↓
契約が邪魔なら、契約自体を外して再検証する
試行錯誤が知見に変わるのは、失敗の理由が次の制約になったときだ。
試行回数だけでは足りません。差分が見え、撤回でき、不採用理由が残り、次のセッションがそれを読めることが必要です。採用しなかった圧縮案、制約解除版、落選した図、解除した正本も、何を外すと何が壊れるかを示す比較対象になりました。
次の本に、今回の正本、チック割当、章構成、反復密度の数値をそのまま持ち込むつもりはありません。それらは、この本の条件の中で生まれたものです。再利用するのは、契約を発見し、試し、更新し、捨てるという制作ループそのものです。
book_state.md
  読者、読了後の変化、構成、締切、ページ予算

writing_contract.md
  現時点で分かっている編集判断

verification_debt.tsv
  未検証の主張、確認先、使用予定章、状態

experiment_ledger.tsv
  仮説、成功条件、観測結果、撤回理由、
  残した資産、新しく生えた契約、再試行条件
最初の数章はAIでドラフトし、少なくとも一章は人間が濃く直します。AI稿と人間稿の差分から、その本固有の編集判断を抽出します。複数章を統合して反復や章間参照を観測し、同じ失敗が二度起き、機械で誤判定しにくいものだけをテストします。重要な章では制約を外した案も作り、契約が文章を妨げるなら契約を更新します。
本の中では、AIエージェントが、短命な実行、状態の外部化、隔離、耐久実行というサーバーレスの原理を再発見しました。その本を作る過程では、私自身が、長編を書くための状態、契約、予算、検証を再発見しました。
AI時代になっても、試行錯誤の量が質へ転化するという原則は陳腐化しそうにありません。むしろ候補を作る費用が下がったことで、試行を知見へ変える工程の価値は上がっています。つくり、壊し、直す。そして、直した理由を次の生成へ残す*1。今回得た一番大きな経験は、百ページを超える本を短期間で書けたことだけではなく、この制作ループを一冊分だけ実際に回せたことです。
生成は、可能性を広げる。工学は、望ましい可能性が残る条件を設計する。
この工程で作った『AIエージェントが見つけたサーバーレス——任せられる実行基盤の設計』の詳細は、書籍紹介ページにまとめています。
今週末のコミックマーケット、そしてその後はオンラインや各種技術同人誌イベントにて頒布予定ですので、よろしくお願いします!
*1:もちろん翔泳社さんの「つくって、壊して、直して学ぶ」シリーズへのオマージュです
