💡 この記事は録音データを元にAIで文字起こししたものです。
2026年9月19日のServerlessDays Tokyo 2026で、「AIエージェントが再発見したサーバーレス」というタイトルで話してきました。
AIエージェントの周辺では、毎週のように新しいサービスが出てきます。それを一つずつ覚えるだけでなく、自分がすでに持っている知識から読み解けないか。そして、その日のほかの講演を理解するための地図を渡せないか。そんなことを考えて組み立てた25分です。
この記事は、当日の録音をもとに、言い直しや重複を整理した講演録です。発言の順序と論旨を基本に、図とコードを当日のスライドから補っています。製品や仕様の説明は登壇時点のものです。記事化にあたって加えた補足は、注記として分けています。
新しく得た知識を、自分の中のどこに置くか
このセッションは、二つのキーノートが終わって、午後の3トラックのセッションが始まるタイミングに置いていただきました。
AIエージェントの分野では、次々にリリースが続いています。その中で、手持ちの知識がどこまで通じるのか、新しいサービスのどこを見ればよいのか。その勘所を持ち帰っていただければと思っています。
さらに、午後のセッションで新しく得る知識を、自分の中でどう整理し、どこに位置づけるか。これからの講演を理解するための地図も提供できれば、というのが今回の狙いです。
クラウドの20年、サーバーレスの11年、ChatGPTからの4年
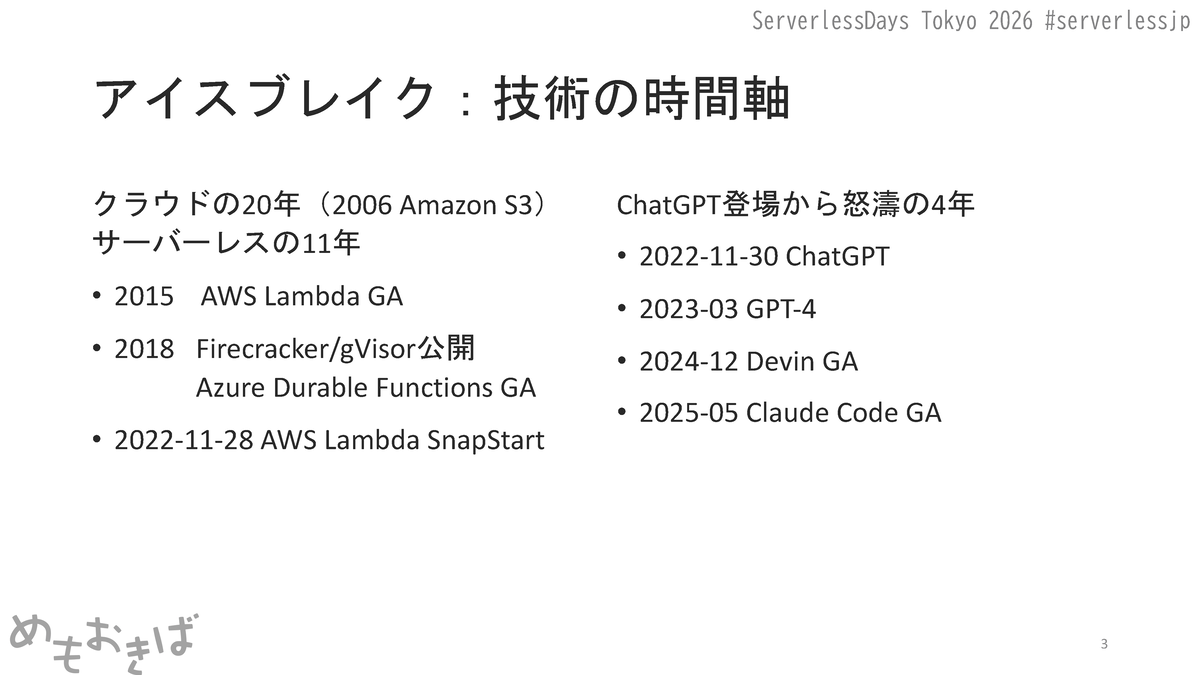
まずは、毎年少しずつお話ししている、技術の時間軸から。
Amazon S3が登場したのが2006年で、今年は20周年です。AWS Lambdaの一般提供開始が2015年なので、こちらは11年が経ちました。その間にも、今のエージェント実行基盤につながる技術が育ってきています。
2018年にはFirecrackerとgVisorが公開され、Azure Durable Functionsも一般提供になりました。2022年11月28日には、AWS Lambda SnapStartが登場しています。
一方、ChatGPTが公開されたのは2022年11月30日。なんと、Lambda SnapStartの2日後です。
そこから2023年3月にGPT-4、2024年12月にDevinの一般提供、2025年5月にClaude Codeの一般提供と、毎年のように鍵になるものが出てきました。今年はCodexの存在感が増したという感覚もあります。
AIの側では、ずいぶん長い時間が経ったように感じるかもしれません。でも、その足元の実行基盤やワークフローの側には、もう少し長い蓄積があります。この二つを同じ時間軸に置いておきたいと思います。
サーバーレスは、Platform Engineeringの一形態
昨年のおさらいを少しします。
私は、サーバーレスをPlatform Engineeringの一形態として捉えています。昨年のスライドでは「Serverless implements Platform Engineering」と書きました。
プラットフォームがベストプラクティスを提供し、開発者は自分の価値に注力する。突き詰めれば、プラットフォームと自分たちの役割を分担するための、さまざまな試みだと思っています。
その一方で、ソフトウェアエンジニアリングの重要性は変わりません。昨年は「誰もが、安全でスケールするソフトウェアを作れる世界でありたい」と書きました。今年はそこに「AIでも」を加えています。
AIがたくさんコードを書くようになった今だからこそ、サーバーレスが育ててきた「良い制約」が、再現性のある、安定した開発を支えるのではないでしょうか。
自由と制約の間を、プラクティスで埋める
もう一つ大事にしているのが、「自由と制約のグラデーション」です。毎年ServerlessDaysに来られている方には、毎年聞いているよ、という話かもしれません。
自由にできる側と、プラットフォームに任せる側。その間のどこに自分たちはいたいのかを考える。その間を埋めていくのが、いろいろなプラクティスです。
たとえば、ワークロード認証や最小権限。これは、AIにコードを書かせたり、いろいろなツールの呼び出しを任せたりする場合にも、改めてきちんとやらなければならないところです。サプライチェーン攻撃の話も含めて、こうしたところを凡事徹底していく必要があると思っています。
データと処理を分けることも重要です。今年は、Claude Mythosの提供が米国政府の指示で停止された例もありました。1 こうしたことを考えると、データをどこに置くのか、処理をどこで行うのかを、それぞれ分けて考えなければなりません。
アーキテクチャを設計するときには、作っているシステムの中身だけを見るわけではないんですね。価格表に表れるコスト構造や、データの所在地、個人情報の扱い、国際関係のような外部の制約もあります。データやインターフェースのロックインも、その一つです。
そうした条件を踏まえて設計することの重要性は、今も変わっていません。
サーバーレスなアーキテクチャの三つの要素
サーバーレスなアーキテクチャは、大きく三つの要素で捉えられると考えています。
一つ目が、フルマネージドサービス。何をクラウドに任せ、何を自分で持つのか。自分で管理するサーバーをなくす、という意味では、いちばん分かりやすい部分です。
二つ目が、イベントドリブンアーキテクチャ。個々の処理をどうつなぎ、全体のワークフローを構成するのか。
三つ目が、プログラミングモデル。自分たちの価値を、どこで、どのように記述するのか。
フルマネージドサービスだけでなく、残りの二つも含めて、この11年間で一緒に育ってきたのがサーバーレスなアーキテクチャだと思っています。
そして、ここに「AIエージェントという新しい需要」が加わりました。
クラウド各社も、それを使う私たちも、この三つを改めていろいろな角度から見るようになっています。
新しい需要から、見慣れた技術を読み直す
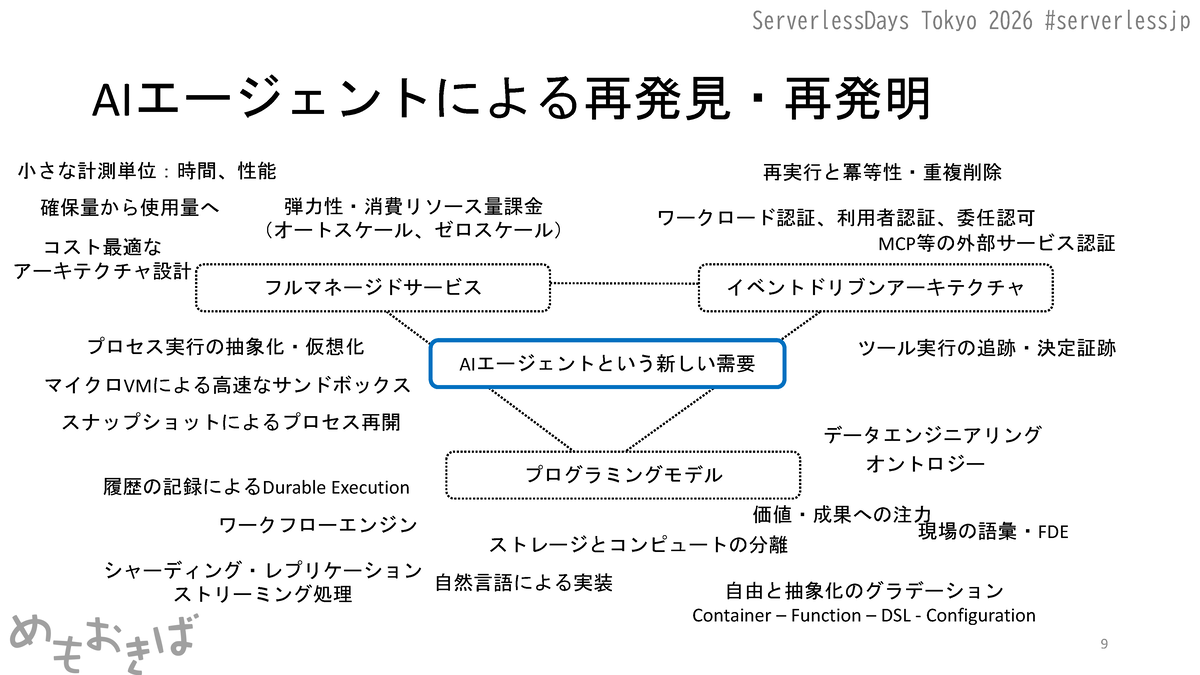
たとえば、午前のキーノートにもMicroVMの話がありました。Firecracker自体は、Lambdaの基盤として以前から使われてきた技術です。高速なサンドボックスがあり、そこにスナップショットの技術を組み合わせることで、プロセスを再開する仕組みとして、エージェントの分野でも使われるようになっています。
ワークロード認証も同じです。これまでも、Lambdaにどんな権限を持たせるかというIAMの話は、皆さん頭をひねりながら考えてきたと思います。
これからは、そこに「誰が、このAIエージェントに、どんな権限を任せたのか」という委任の話が加わります。
フルマネージド、イベントドリブン、プログラミングモデル。これらを考える中で育ってきたキーワードを、別の需要から読み直している。それが、この1、2年で起きていることの一つではないかと思っています。
「全部新しい」と「全部昔からある」の間
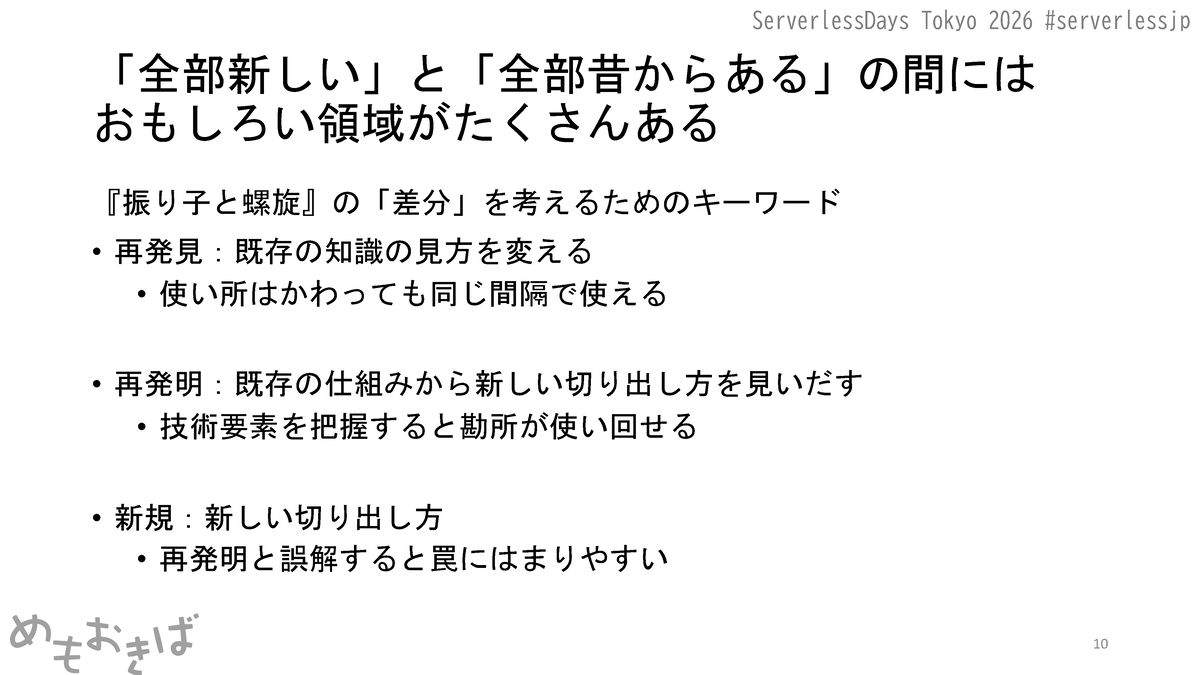
「これは全部新しい」と「それは全部昔からある」の間には、おもしろい領域がたくさんあります。
技術の変化を、分散と集中の間を行き来する振り子として説明することがあります。ただ、同じ場所を往復しているだけではなく、そのたびに少しずつ変わっている。螺旋のように進んでいる、と見ることもできます。
その差分を考えるために、今回は「再発見」「再発明」「新規」という言葉を使います。
再発見:既存の知識の見方を変える
ユースケースや使いどころは変わっても、似た感覚で使えるものです。
たとえば、AIエージェントをホストするサーバーレスのサービスでも、呼び出し方やコマンドに違いはあっても、使い方の感覚や、裏側で動いているものには見覚えがある。そういう部分は、既存の知識を持ち込めます。
再発明:既存の仕組みから、新しい切り出し方を見いだす
技術要素自体はまったく新しいものではなくても、それらを組み合わせ直し、違う単位のサービスとして提供するものです。
Firecrackerを使った隔離の技術を、長く続くエージェントの実行環境として、改めて使えるようにする。こうした例は、午前のキーノートともつながります。
サービスとしての使い方は違っても、その技術要素を把握すれば、これまで培ってきた勘所を使い回せます。
新規:これまでの類推だけでは捉えきれないもの
もちろん、本当に新しいものもあります。それを単なる再発明だと思い込んで、「あの技術はこうだったから、これもこうだろう」と考えると、罠にはまることがあります。
新しいサービスやリリースノートを見るとき、あるいはこの後の講演を聞くときに、どれに当たるのだろう、と少し意識してみてください。AIエージェントに限らず、自分の中に知識を位置づけるための見方として使えると思います。
実行基盤の収斂進化
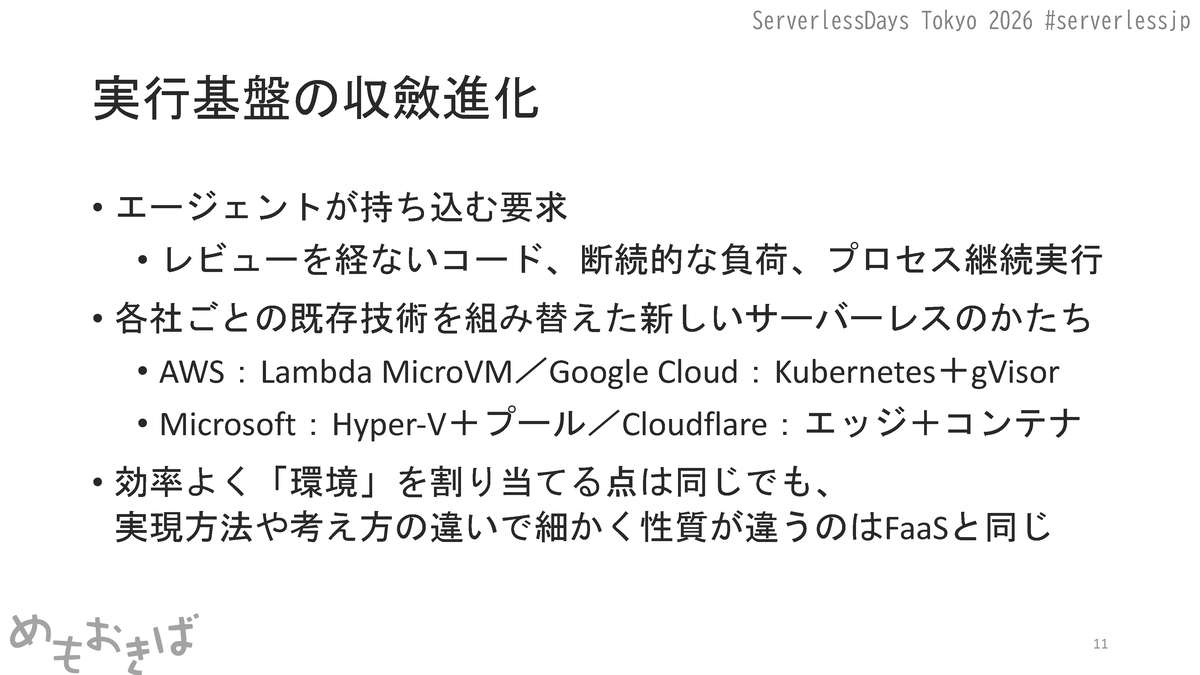
この「再発見」という言葉を使った理由の一つに、実行基盤の収斂進化を感じていることがあります。
生物学でいう収斂進化は、別々の系統でも、似た要求に応える中で似た姿になる、という話です。講演では、カニのような姿に近づく生き物などを例にしました。同じようなことが、エージェント向けの実行基盤にも起きているのではないでしょうか。
AIが書いた、人間のレビューを経ていないコードを実行したい。断続的な負荷を扱いたい。プロセスを継続して使いたい。エージェントが持ち込む需要が共通しているので、各社も似た方向へ進んでいるわけです。
ただ、各社が出発点として持っている技術は異なります。当日のスライドでは、次のように並べました。
| 提供者 | スライドで取り上げた実行基盤の系譜 |
|---|---|
| AWS | Lambda MicroVMs |
| Google Cloud | Kubernetes+gVisor |
| Microsoft | Hyper-V+プール |
| Cloudflare | エッジ+コンテナ |
各社が自分たちの持つ技術を組み替えて、新しいサーバーレスの形を提供しています。たとえばLambda MicroVMsは、従来のLambdaと同じFirecrackerの技術を土台にしています。2
大事なのは、効率よく環境を割り当てるという方向は同じでも、実現方法や考え方によって細かい性質は違うことです。これは、従来のFaaSでも各社に違いがあったのと、よく似ています。
例:同じスナップショットでも、戻したいものが違う
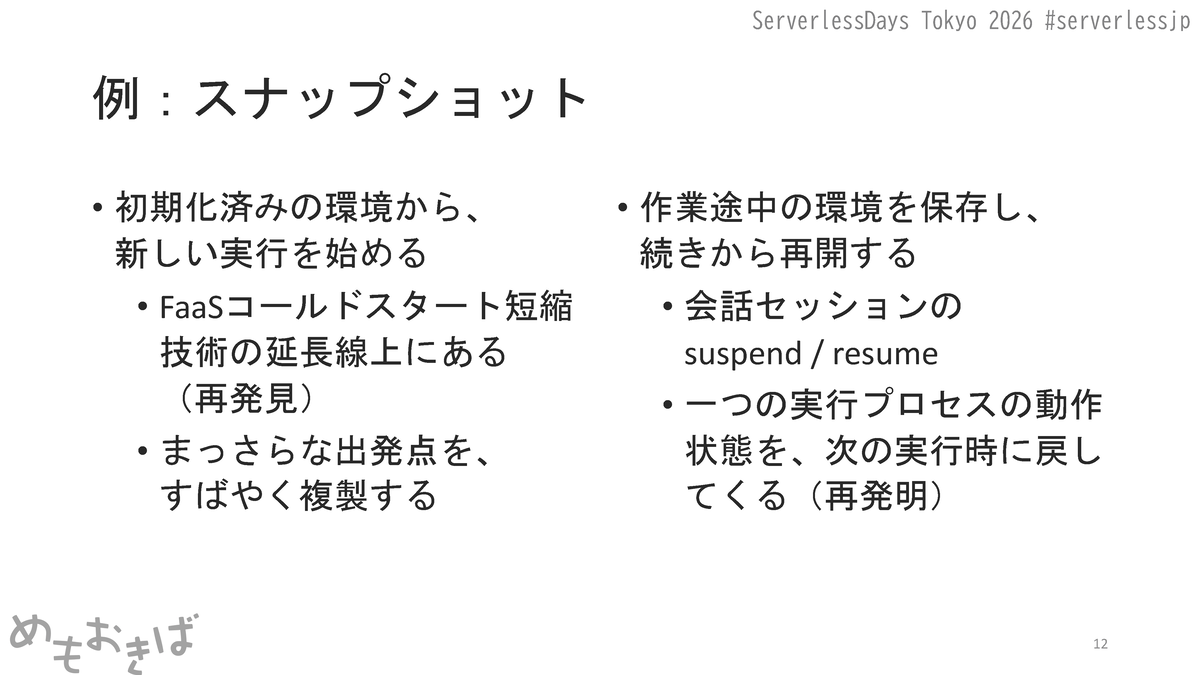
スナップショットを例に考えてみます。
Lambda SnapStartでは、あらかじめ初期化を済ませ、その時点のスナップショットを用意しておきます。新しい実行をそこから始めることで、コールドスタートを短くする。まっさらな出発点を、すばやく複製するための技術です。3
この考え方をエージェントの実行基盤にも使う、というところは、再発見として読めます。
一方、作業途中の環境を保存して、その続きから再開したい場合もあります。メモリなどの動作状態を保存し、会話セッションをsuspend / resumeするような使い方です。
こちらは、新しい処理の出発点を複製したいのではなく、一つの実行プロセスの途中状態を次の実行へ戻したい。同じスナップショットでも、求めている動作が違います。
従来のFaaSでは、一つのリクエストが終わったあとの環境を、その仕事の続きとして引き継ぐことを中心には考えていませんでした。4 エージェントの文脈では、そこが改めて必要になった。蓄積してきた技術を使って、違う使い方を切り出したという意味で、私は再発明として捉えています。
高レイテンシーが許された特別な時間の終わり
少し違う切り口の話もしてみます。
この見出しは、watanyさんのスライド『エンジニアに許された特別な時間の終わり』のタイトルをもじったものです。5
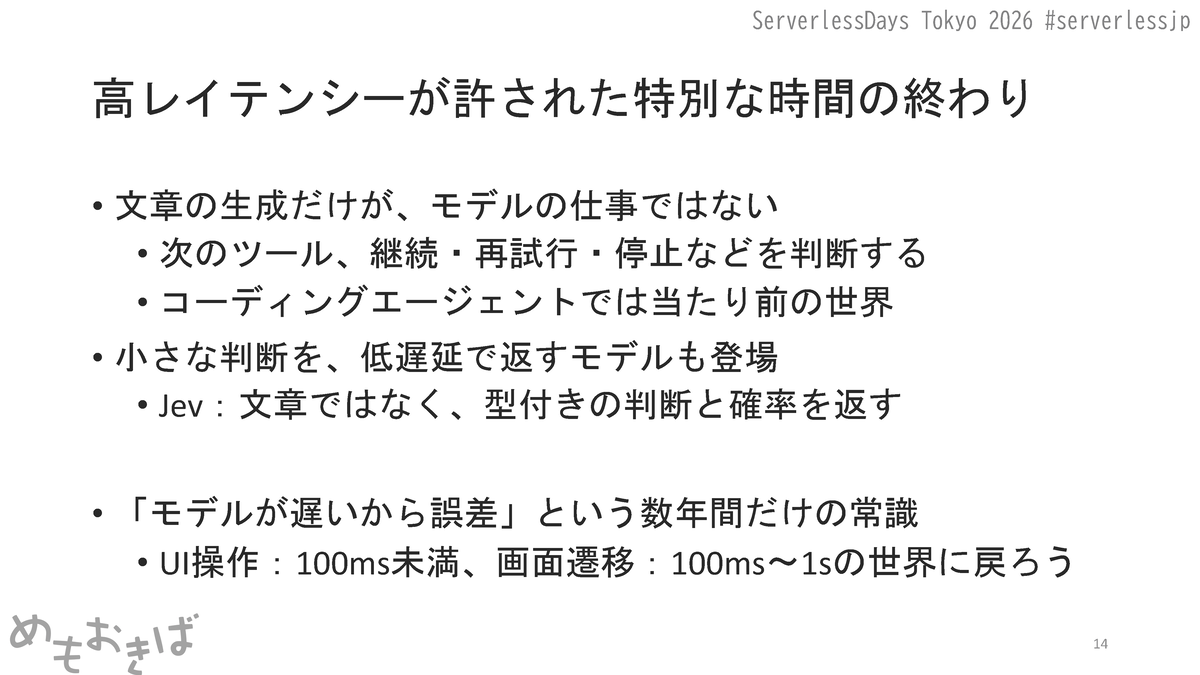
文章の生成だけがモデルの仕事ではないことは、コーディングエージェントを使っているとよく分かります。次にどのツールを呼ぶのか。処理を続けるのか、再試行するのか、停止するのか。いろいろな判断をしています。
講演では、この数日で話題になったJevを、文章ではなく型付きの判断と確率を返す、低遅延モデルの例として紹介しました。ローカルモデルも含めて、小さな判断を短い時間で返す選択肢が増えてきています。
すると、「どうせモデルが遅いから、秒単位、場合によっては分単位で待ってもいい。プロセスのコールドスタートは気にしなくてよい」という、この数年間だけの常識を、もう一度見直す必要が出てきます。
UIを操作したら100ms以内に反応してほしい。画面遷移も100msから1秒くらいで進んでほしい。講演では、そういう人間の感覚に合う応答の世界へ戻ろう、という話をしました。6
これも一種の再発見というか、以前から知っている現実に戻ろう、という話だと思います。
応答時間と処理時間を分ける
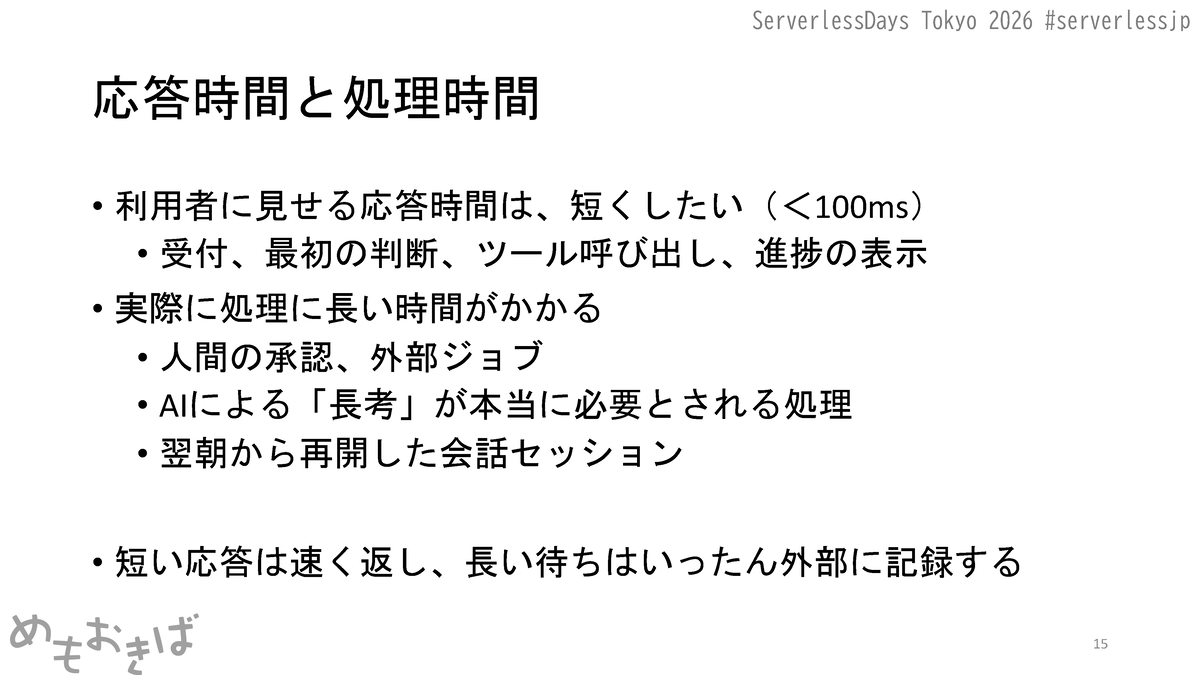
では、どう実現するのか。ここでは、応答時間、もう少し言えば操作への反応時間と、実際の処理時間を分けます。
利用者がUIを操作したら、まず短い時間で反応してほしい。一方、処理自体に時間がかかるものは、どうしてもあります。
人間の承認や、外部ジョブの完了待ちもそうですし、AIが本当に長く考えなければならない仕事もあります。
そうしたときには、UIではまず反応を返し、砂時計などで処理中だと示す。処理に時間がかかることと、操作に何も反応しないことは別に考えたいわけです。
逆に、人間の方が待たせている場合もあります。会話をいったん止めて、翌朝から再開するような場面です。
短い応答は速く返す。その上で、長い待ちはいったん外部に記録する。こうした考え方が必要になります。
Durable Functionsも、再発見として読める
この文脈で、改めて注目されているのがDurable Functionsです。
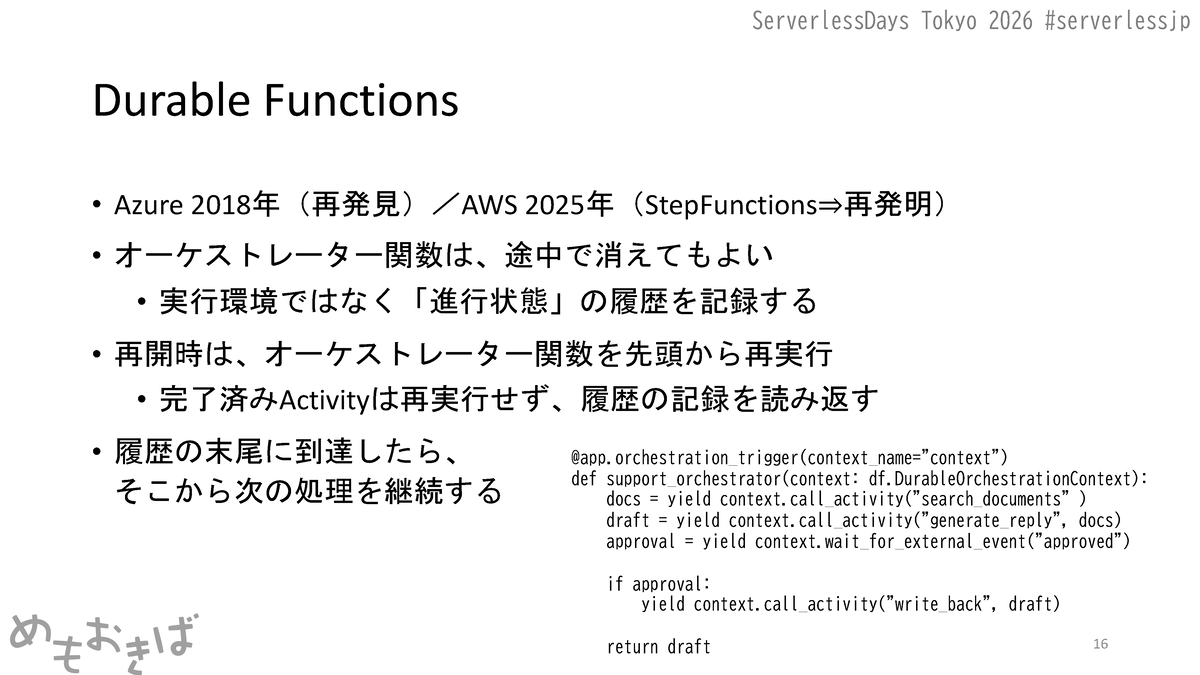
Azureでは2018年から一般提供されていたので、これは、そのまま使える技術の再発見という見方ができます。AWSにも以前からStep Functionsがありましたが、関数としてワークフローを書く形も便利です。2025年に登場したLambda durable functionsは、そうした切り出し方の再発明の一つとして位置づけられると思っています。7
当日は、この後に関連するセッションがあるので、詳しい仕組みの説明はそちらへ委ねました。
基本となるのは、オーケストレーター関数自体は途中で消えてもよい、という考え方です。実行環境そのものではなく、進行状態の履歴を記録しておき、その履歴を読み返して、続きから処理を進めます。
以下は、当日のスライドに載せたAzure Durable Functionsのコードです。初期化やActivityの定義を省略した説明用の抜粋です。
@app.orchestration_trigger(context_name="context")
def support_orchestrator(context: df.DurableOrchestrationContext):
    docs = yield context.call_activity("search_documents")
    draft = yield context.call_activity("generate_reply", docs)
    approval = yield context.wait_for_external_event("approved")

    if approval:
        yield context.call_activity("write_back", draft)

    return draft
スライドでは、再開時には関数を先頭から再実行し、完了済みのActivityは再実行せず、履歴の結果を読み返す、と整理しています。履歴の末尾へ来たら、そこから新しい処理を進めるわけです。8
こうした仕組みも、再発見と再発明という見方で整理すると、自分の知識につなぎやすいと思います。
MCPも「ステートレス」を再発見した
サーバーレスそのものからは少し外れますが、MCPにも似た話があります。AIからツールや外部のサービスを呼び出すための仕組みです。
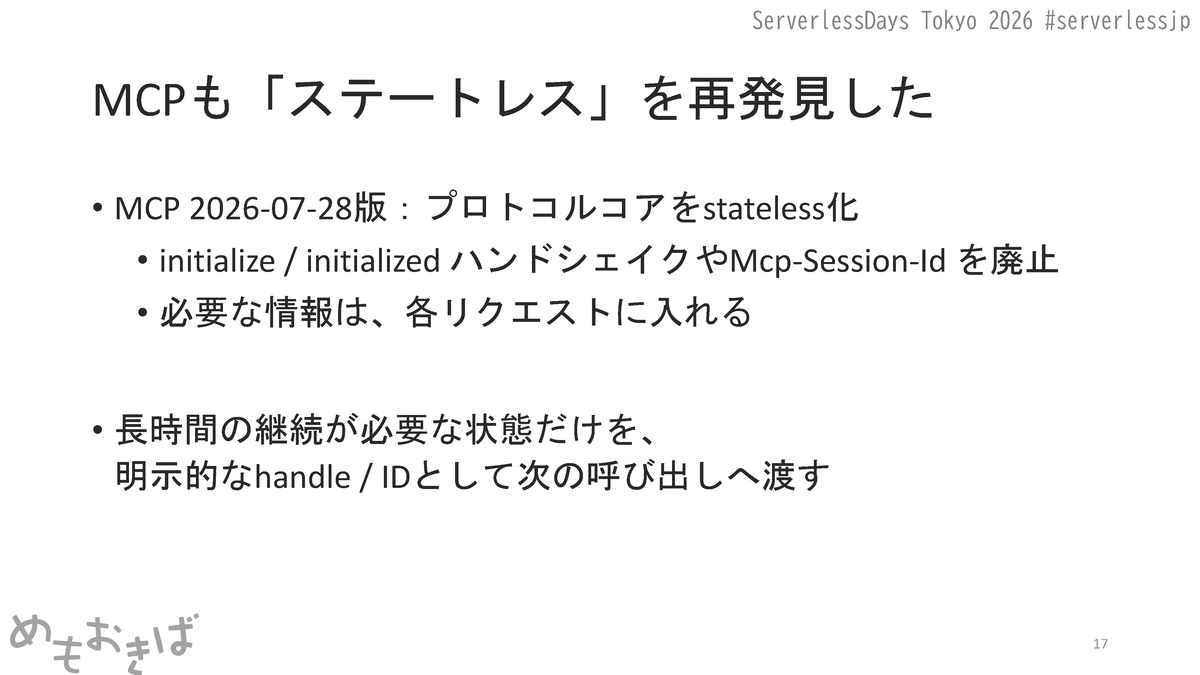
当日は、接続を維持してやり取りするプロトコルから、ステートレスなプロトコルへ変わった、という説明をしました。MCPの2026-07-28版では、プロトコルのコアがステートレス化されています。9
initialize / initializedのハンドシェイクやMcp-Session-Idを廃止し、必要な情報をそれぞれのリクエストへ入れる。一方、長時間にわたって継続が必要な状態は、明示的なhandleやIDとして、次の呼び出しへ渡します。
長く続く状態までなくすのではなく、継続に必要なものを明示的に持ち回る。先ほどのDurableの話と、共通する見方ができるところです。
技術選定は、導入した日で終わらない
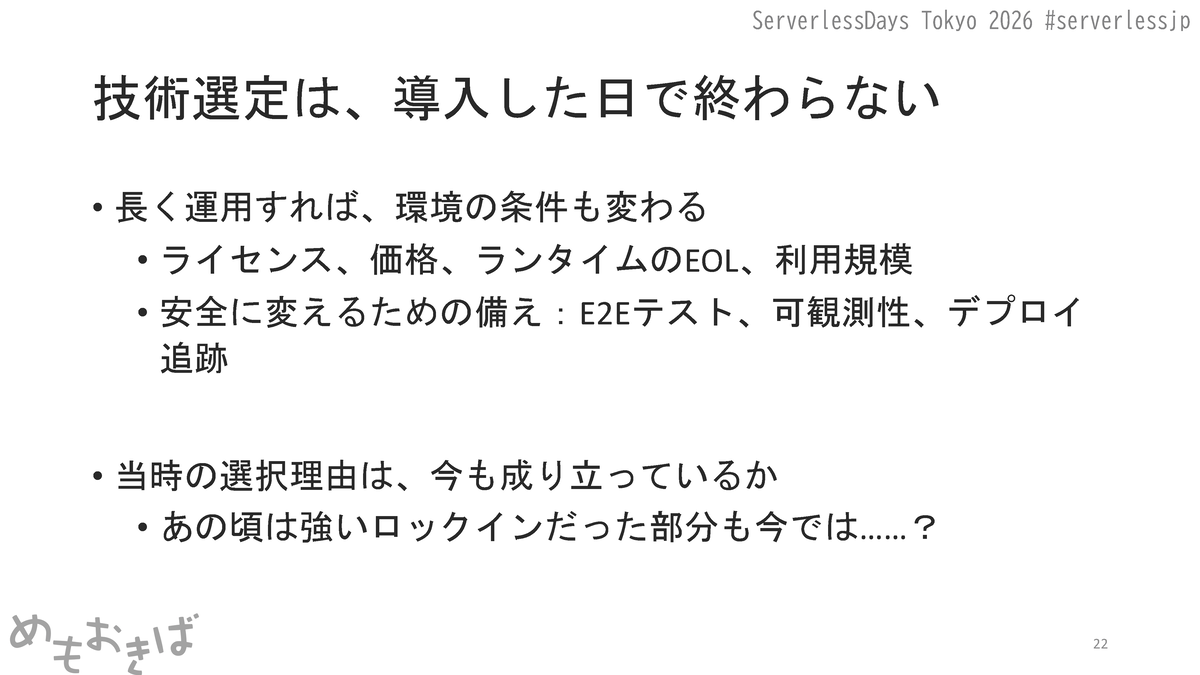
MCPも、最初に設計したときとは違うものが必要になり、大きく仕様を変えた例として読めます。技術選定は、最初にそう決めた日で終わるわけではありません。
長く運用すれば、いろいろな条件が変わります。使っている言語がEOLになって、Lambdaのランタイムを更新しなければならない、といった経験のある方も多いのではないでしょうか。ライセンスや価格、利用規模も変わります。
安全に変えるには、E2Eテストや可観測性、デプロイの追跡といった備えが必要です。その上で、当時の選択が今でも成り立っているかを考え直します。
再発見・再発明という文脈でサービスを自分の中に位置づけ直すと、改めて選択する機会が見えてくると思っています。
たとえば、あの頃は強いロックインだった部分も、今は状況が変わっているかもしれません。仕様がきちんと文書化されていれば、Lambdaに依存する外側の部分をAIコーディングで書き換え、中のロジックを活かして別のクラウドへ載せる。オンプレミスへ持っていく方向もあるでしょう。
逆に、もともとローカルやオンプレミスで動いていたアプリケーションを、Lambda Web Adapterでサーバーレスの環境へ持っていく方向もあります。
すべて簡単に移せるということではありませんが、以前と比べて、選び直すための手段も変わってきたのではないかと思っています。
書いたコードでも、持ち続ける必要はない
その中で、もう一つ考えたいのが、自分で書いたコードを、いつまで持ち続ける必要があるのかということです。
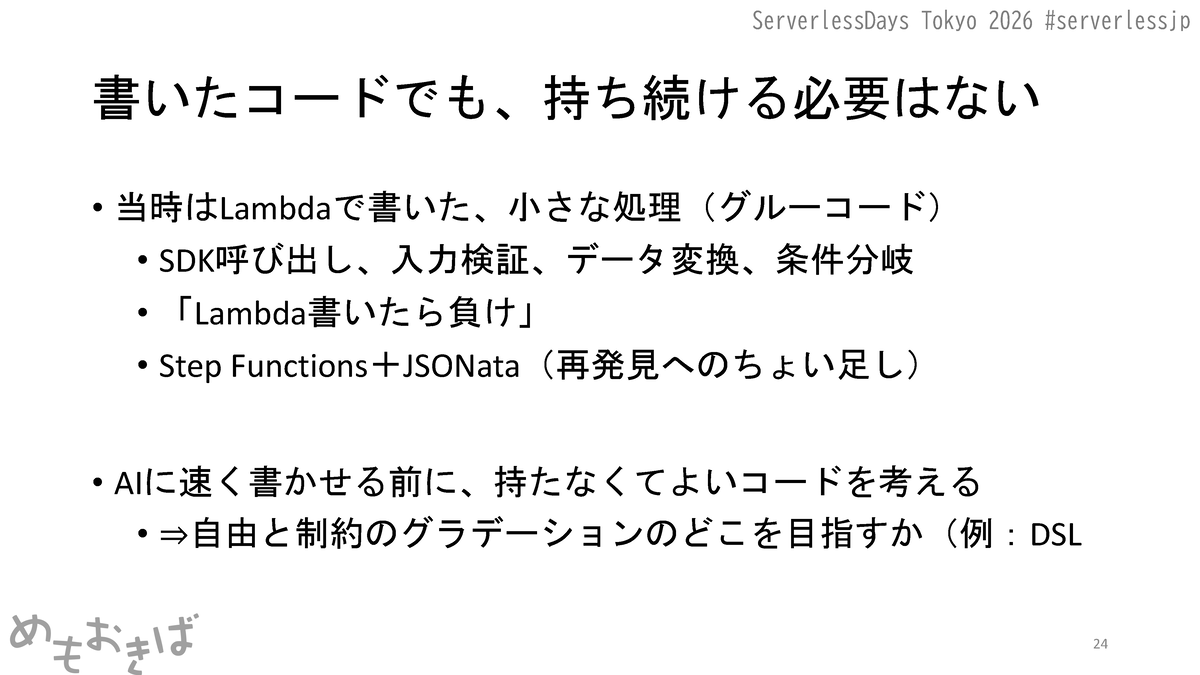
10年前にはLambdaで書く必要があった小さな処理が、たくさんあったと思います。SDKの呼び出し、入力の検証、データ変換、条件分岐。いわゆるグルーコードです。そのためにLambdaの数が増えている、という方もいるのではないでしょうか。
私は以前から「Lambda書いたら負け」という、ちょっと物騒な言い方もしています。ここで考えたいのは、わざわざ自分で持たなくてよいコードまで、持っていないかということです。
たとえば、Step FunctionsとJSONataを組み合わせると、以前より書きやすくなった処理があります。もともとの仕組みに少し足されることで、改めて使いどころが広がる。「再発見へのちょい足し」のようなものとして見ています。
大事なのは、AIに速く、たくさん書いてもらう前に、持たなくてよいコードを考えることです。結局これは、自由と制約のグラデーションのどこを目指すのか、という最初の話へ戻ってきます。
この地図を、次のインプットに使ってほしい
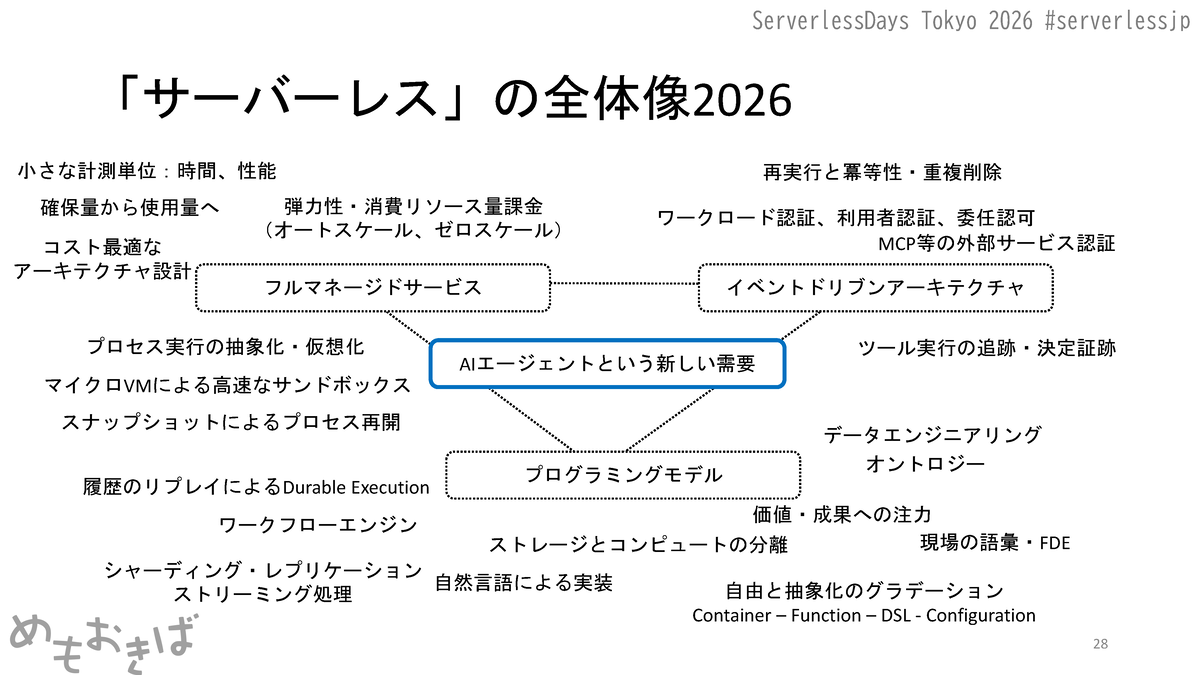
ここまでの話を、もう一度サーバーレスの全体像へ戻してみます。
当日は、この後のセッションを聞きながら、さらに書き足していきたいとお話ししました。
再発見なのか、再発明なのか、それとも新しいものなのか。そのキーワードを少し意識しながら、いろいろなセッションを楽しんでもらえればと思います。
自分の中のどこへ置けるのか、何の知識を使えるのかを考えながら聞くことで、それぞれの話のつながりも見えてくるのではないでしょうか。
いろいろなアウトプットで、化学反応を起こそう
最後は、アウトプットの話です。
アウトプットには、いろいろな形があります。もちろんブログもそうですが、SNSへの短い投稿でもかまいません。
セッションの内容をそのまま投稿するだけではなく、それに対して自分が思ったことを一言足してみる。そんな小さなことが、コミュニケーションのきっかけになることもあります。
今回も3トラックありますが、参加できなかったトラックに、ハッシュタグを通じて擬似参加することもできます。
地図を受け取って終わりではなく、自分の知識につないで、少し言葉にしてみる。そうしたやり取りも含めて、ServerlessDaysを楽しんでいただければと思っています。
今回の話に関連する内容は、技術同人誌『AIエージェントが見つけたサーバーレス——任せられる実行基盤の設計』でも扱っています。
注記・参考資料
以下は、録音の発言とは分けて、記事化にあたり参照先と補足を付けたものです。
- ここでは、2026年6月の提供停止の出来事を指しています。公開時点の継続的な利用可否を述べたものではありません。参照:Anthropicによる2026年6月12日の声明。↩
- 参照:AWSによるLambda MicroVMsの発表。四社の表は当日のスライドの整理であり、各社の全サービスを一種類の隔離方式に分類するものではありません。↩
- 参照:AWS Lambda SnapStartの発表。初期化済み環境のスナップショットを、新しい実行環境の起動に利用する仕組みです。↩
- 記事化時の補足: ウォーム環境の再利用やローカルキャッシュが存在しないという意味ではありません。ここで対比しているのは、初期化済み状態から新しい実行を始めることと、利用者の仕事の途中状態を指定して再開することです。↩
- 見出し表現の参照元:watanyさん『エンジニアに許された特別な時間の終わり』(2025年3月13日、Speaker Deck)。↩
- 記事化時の補足: 数値はUIの応答性を考える目安で、全APIやモデル呼び出しの完了に一律の締切を課すものではありません。Jakob Nielsenは、0.1秒を瞬時に反応していると感じる目安、1秒を思考の流れを保つ目安として整理しています。参照:Response Times: The 3 Important Limits。↩
- 参照:2025年12月のLambda durable functions発表。「再発明」は講演での見立てで、Step Functionsの内部実装を転用したと主張しているわけではありません。↩
- 記事化時の補足: ここで再実行を省けるのは、結果が履歴に記録された処理です。リプレイを成立させるため、オーケストレーターのコードには決定性が求められます。コード例は仕組みの説明用で、承認イベントの送信元検証、承認対象の照合、タイムアウトなどの本番向け設計は省略しています。参照:Microsoft Learn「Durable orchestrations」。↩
- 記事化時の補足: 口頭の「TCPのコネクションを張りっぱなし」という表現は、セッションや継続的な双方向通信を指す説明として整理しました。MCPの全トランスポートがTCP接続を必須とする、という意味ではありません。変更対象は2026-07-28版のプロトコルコアで、旧バージョンとの混在や各SDKの移行対応とは区別する必要があります。参照:MCP公式の2026-07-28版リリース記事。↩